转载、参考: https://zhuanlan.zhihu.com/p/1910636263666610461
最佳参考: http://caomaolufei.github.io/AIInfraGuide/cuda/%E6%A8%A1%E5%9D%97%E4%BA%8C-cuda%E7%BC%96%E7%A8%8B%E4%B8%8E%E7%AE%97%E5%AD%90%E4%BC%98%E5%8C%96/41-cuda-gemm%E7%AE%97%E5%AD%90%E6%80%A7%E8%83%BD%E4%BC%98%E5%8C%96/
速记
优化思路
1. navie版 memory bound
2. 分块计算
    如何分块、K切分
    如何加载A\B 写入C,实现访存合并
3.
计算量推导
矩阵乘法:
\(C = \alpha AB + \beta C\)
\(A\) 形状为 \(M \times K\) ,\(B\) 形状为 \(K \times N\) ,\(C\) 形状为 \(M \times N\)。
矩阵 \(A\)(\(M \times K\))与 \(B\)(\(K \times N\))相乘,得到 \(C\)(\(M \times N\))。
每个 \(C_{i,j}\) 的计算:
每个元素需要 \(K\) 次乘法和 \(K-1\) 次加法,计算\(AB\)需要\((2K-1)MN\)次浮点计算,缩放\(MN\)和\(C\)各需要\(MN\)次计算,最后两个矩阵相加需要\(MN\)次计算,总计算为\((2K-1)MN+MN+MN+MN = (2K+2)MN\)次计算,约为2MNK次计算。
navie
每个 thread 负责 C 中一个元素的计算
1 |
|
问题:全局显存访问 2MNK,全局带宽占用受限制
用算术强度量化一下瓶颈有多严重。算术强度 = 浮点运算量 / 数据搬运量,衡量每搬运 1 字节能驱动多少次浮点运算。以 V100 为例,峰值算力 15.7 TFLOPS、HBM 带宽 900 GB/s,平衡点约为 \(15.7 \times 10^{12} / (900 \times 10^{9}) \approx 17.4\) FLOPs/Byte——高于它受计算限制,低于它就受带宽限制。
朴素实现里每个线程独立计算一个 \(C_{i,j}\),沿 K 维度做内积。计算一个 \(C_{i,j}\) 需要:
- 读 A 的第 \(i\) 行:\(K\) 个 float = \(4K\) 字节
- 读 B 的第 \(j\) 列:\(K\) 个 float = \(4K\) 字节
- 写回 \(C_{i,j}\):1 个 float = \(4\) 字节
- 完成 \(K\) 次乘加:\(2K\) 次浮点运算
C 的写回只有 4 字节,相对 \(8K\) 字节的读取量可以忽略(K 通常几百到几千)。0.25 远低于平衡点 17.4,严重受带宽限制,实测通常只有理论峰值的 6%~11%。根本原因在于数据复用几乎为零:A 的同一行会被计算不同 \(j\) 的线程反复读取,B 的同一列会被计算不同 \(i\) 的线程反复读取,所有重复访问都打到 Global Memory 上。
思路:转移到 shared_memory
分块计算
切入点:算术强度提升
朴素实现的算术强度过低,带宽bound。需要提高数据复用,通过分块让数据在SRAM中被多次使用,减少内存搬运:把 C 切成 \(BM \times BN\) 的分块,每个 Thread Block 负责一块,把这块需要的 A、B 子块搬进 Shared Memory,让块内所有线程反复复用。
把 C 划分成 \(BM \times BN\) 的分块,每个 Thread Block 负责一块。计算这一块 C 时,需要 A 的一个 \(BM \times K\) 行块和 B 的一个 \(K \times BN\) 列块。把这两个子块搬进 Shared Memory,块内所有线程就能反复复用。
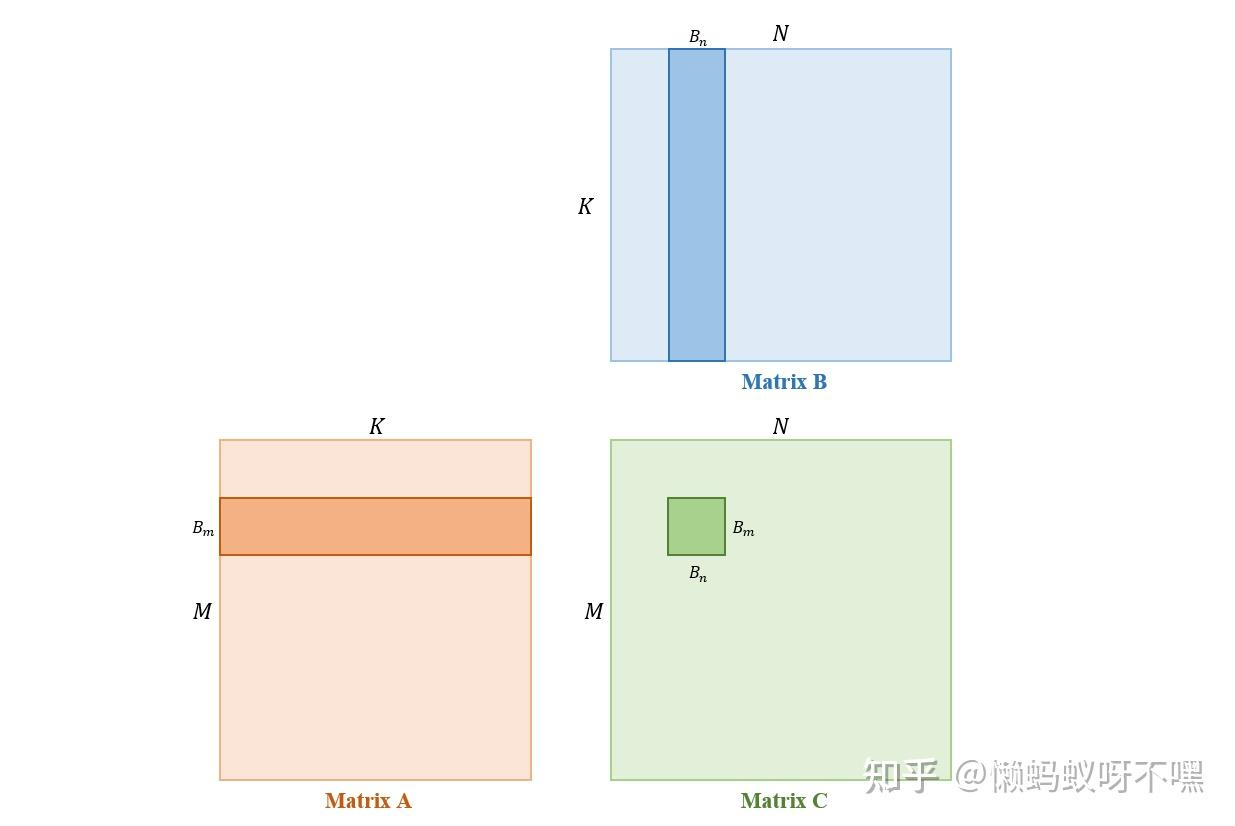
但 K 通常有几千甚至上万,\(BM \times K\) 和 \(K \times BN\) 两个子块加起来动辄几十 MB,而单个 SM 上的 Shared Memory 一般只有 48~228 KB,根本塞不下。所以沿 K 方向再切成大小为 \(BK\) 的小块,分批载入 Shared Memory 累加:
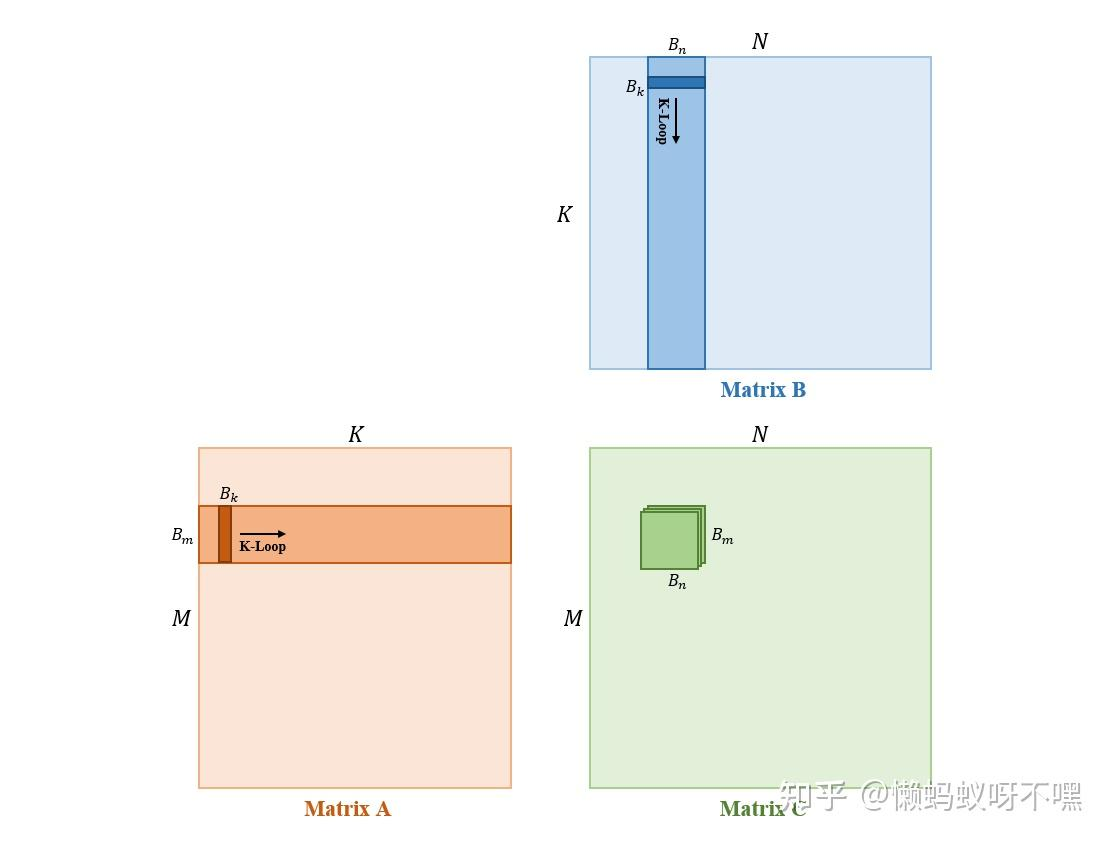
从整个 block 视角算算术强度(一次性算完整个 \(BM \times BN\) 块,跨所有 K):
- 计算量:\(2 \cdot BM \cdot BN \cdot K\) FLOPs
- 访存量:读 A 的 \(BM \times K\) 行块 + 读 B 的 \(K \times BN\) 列块 + 写回 C 的 \(BM \times BN\) 块,共 \(4(BM \cdot K + K \cdot BN + BM \cdot BN)\) 字节
C 的写回项 \(BM \cdot BN / K\) 在 K 远大于 \(BM\)、\(BN\) 时可以忽略(典型场景 K=4096、BM=BN=128 时该项仅占 ~1.6%),化简后得到与朴素实现同构的形式:
注意这个结果与 \(BK\) 无关——\(BK\) 只决定 K-Loop 分多少轮,不影响整块算下来的总访存和总算术强度。化简后的形式还能看出:在 \(BM + BN\)(Shared Memory 占用)固定的约束下,由均值不等式,\(BM = BN\) 时算术强度最大。
取 \(BM = BN = 128\):
32 已远超平衡点 17.4,Global → Shared 这一级搬运不再是瓶颈。相比朴素实现的 0.25,算术强度提升 128 倍——这就是分块的核心收益。同时,每次载入 Shared Memory 的子块会被 block 内 \(BM \times BN\) 个输出元素协同复用,Global Memory 访问量从 \(O(MNK)\) 降到 \(O(MNK / BK)\) 量级。
** \(BK\) 选择 **
算术强度与 \(BK\) 无关,那 \(BK\) 取多大?这是 Shared Memory 占用和同步开销之间的权衡:
- 取大了 Shared Memory 占用涨:\(BM \cdot BK \cdot 4\) 字节,\(BK=8\) 时 4 KB,\(BK=16\) 时 8 KB
- 取小了 K-Loop 迭代次数多(\(K / BK\) 轮),每轮两次
__syncthreads()的同步开销变大
综合下来 \(BK = 8\) 是个比较稳的折中。最终参数定为 \(BK = 8\),\(BM = BN = 128\)。
沿 K 切分是 GEMM 分块优化的黄金法则,后面所有更深层级的优化(线程分块、Warp 分块)也都沿用这个原则——在每一级存储层级上(Global → Shared → Register)都是沿 K 方向逐步迭代累加,让每份数据被尽可能多的下游计算复用。
协作加载时线程怎么排布
加载 tileA 和 tileB 时,线程的排列方式直接决定了 Global Memory 访问是不是合并的(Coalesced Access)——同一个 warp 内的 32 个线程必须访问连续的内存地址,否则一次访存会被拆成多次,带宽利用率暴跌。
Block 里共 256 个线程(tid = 0..255),但加载两个 tile 需要的形状完全不同,所以同一批线程在两个加载阶段要重排成不同的二维坐标:
- 加载 tileA(\(128 \times 8\)):一行只有 8 个元素,让 8 个相邻线程负责一行。256 个线程重排成 \(32 \times 8\)(32 行 × 8 列),每轮覆盖 32 行,循环 4 次覆盖 128 行。
- 加载 tileB(\(8 \times 128\)):一行有 128 个元素,让 32 个相邻线程负责一行的连续段。256 个线程重排成 \(8 \times 32\)(8 行 × 32 列),一轮就能覆盖所有 8 行。
1 | int tid = threadIdx.x; |
这样排布的好处是:加载 tileB 时,一个 warp 恰好覆盖一行的 32 个连续 float,是一次完美的合并访问;加载 tileA 时,warp 内 32 个线程覆盖连续 4 行 × 8 列,每行内部也是连续的,同样能合并。
输出 tileC 的线程划分
\(128 \times 128\) 的 tileC 一共 16384 个元素,256 个线程每个要负责 64 个。直接按行切会让相邻线程访问跨度很大,不利于写回时的合并访问。这里的做法是把 tileC 划分成若干个 \(16 \times 16\) 的小 C_BLOCK:
- X 方向有 \(Tn = BN / 16 = 8\) 个
C_BLOCK,Y 方向有 \(Tm = BM / 16 = 8\) 个C_BLOCK,总共 64 个。 - 256 个线程排成 \(16 \times 16\) 的网格,每个线程在 64 个
C_BLOCK的相同位置各输出一个值,总共 \(8 \times 8 = 64\) 个元素。
1 | constexpr int C_BLOCK_X = 16; |
注意每个线程负责的 \(8 \times 8\) 个输出元素并不是连续排布的,而是以 16 行、16 列为间距跨步分布——这种排布是为了让 256 个线程在写回 C 时也能保持合并访问。
整体流程
把上面的零件组装起来,K-Loop 的每一轮做四件事:
- 协作加载 A 的 \(BM \times BK\) 子块到
As,B 的 \(BK \times BN\) 子块到Bs __syncthreads()等所有线程搬完- 在 Shared Memory 上做局部乘累加,结果累加到寄存器数组
Ct __syncthreads()等所有线程算完,下一轮才能覆盖As、Bs
K-Loop 跑完后,把 Ct 写回 Global Memory 上 C 的对应位置。两次 __syncthreads() 都不能省:第一次保证数据加载完成后再计算,第二次保证计算完成后再覆盖 Shared Memory。
代码实现
1 | template <int BM, int BN, int BK, int BLOCK_SIZE> |


